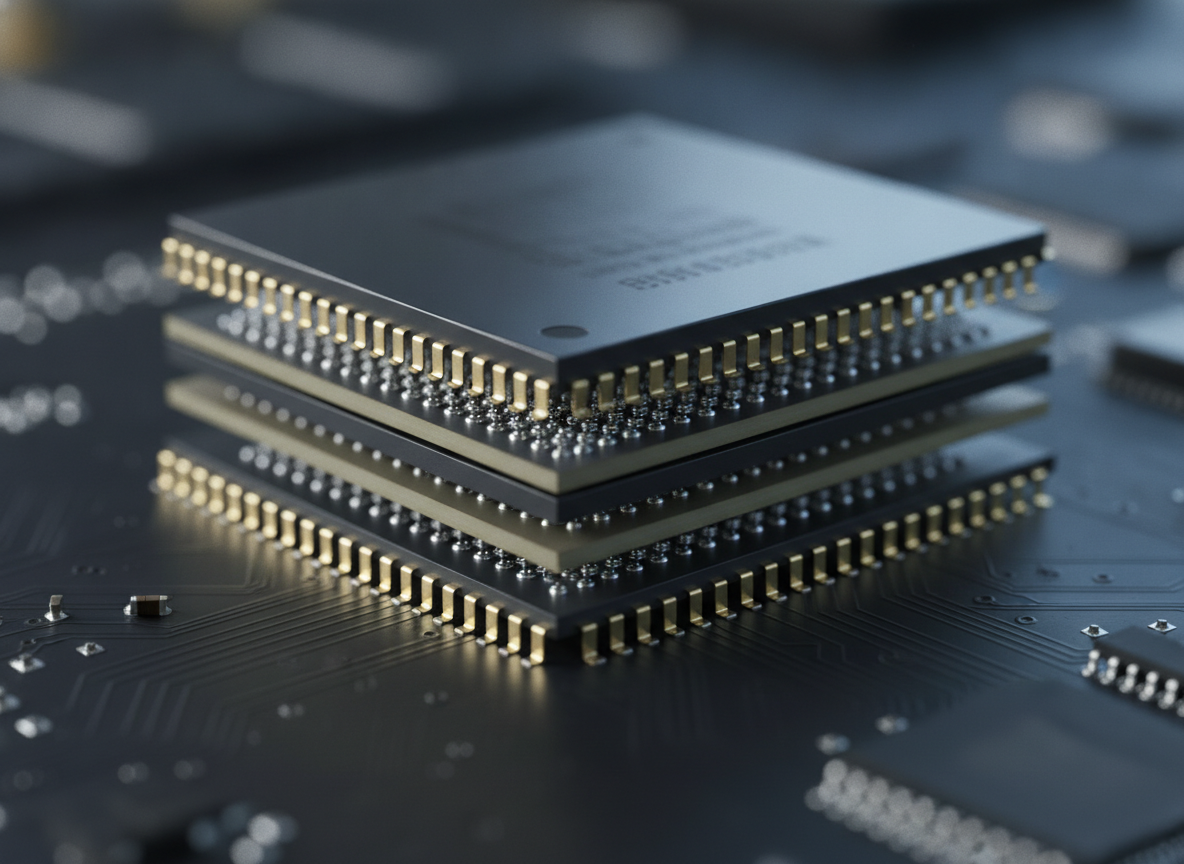
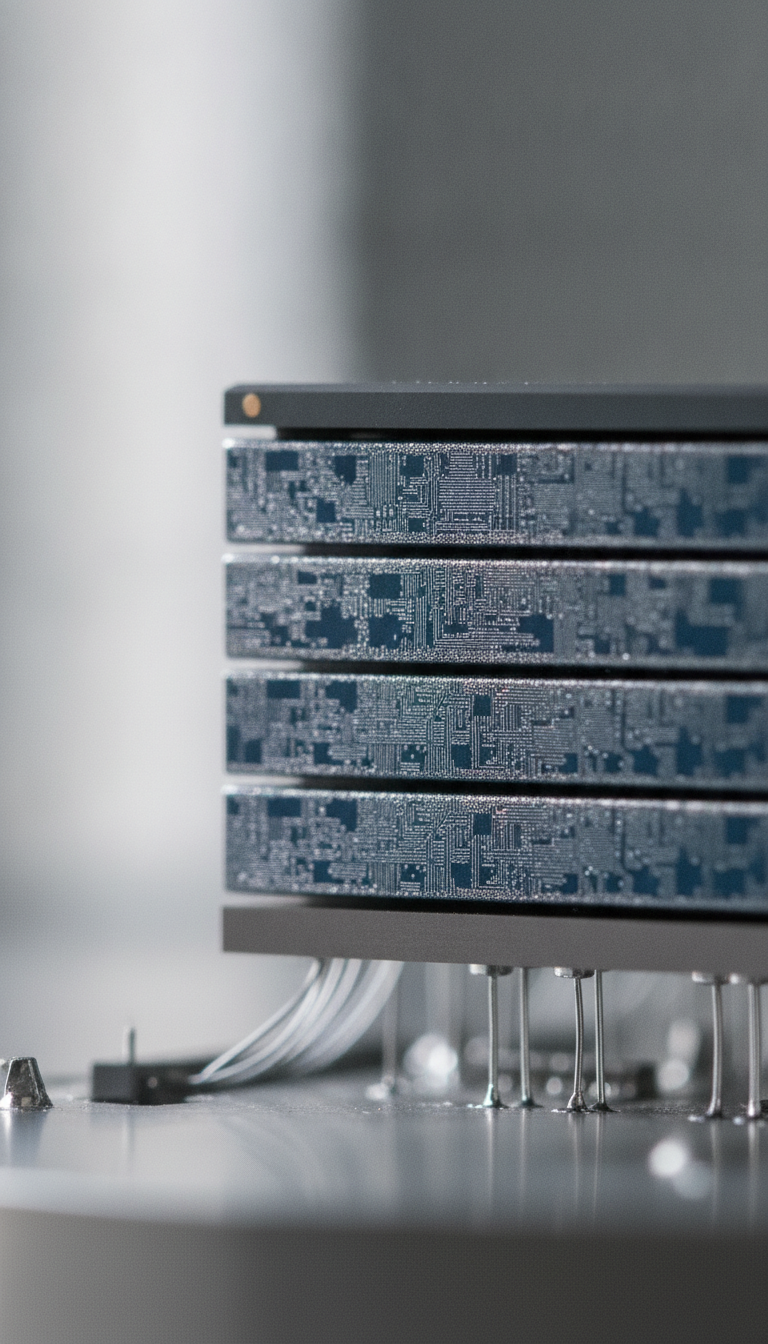
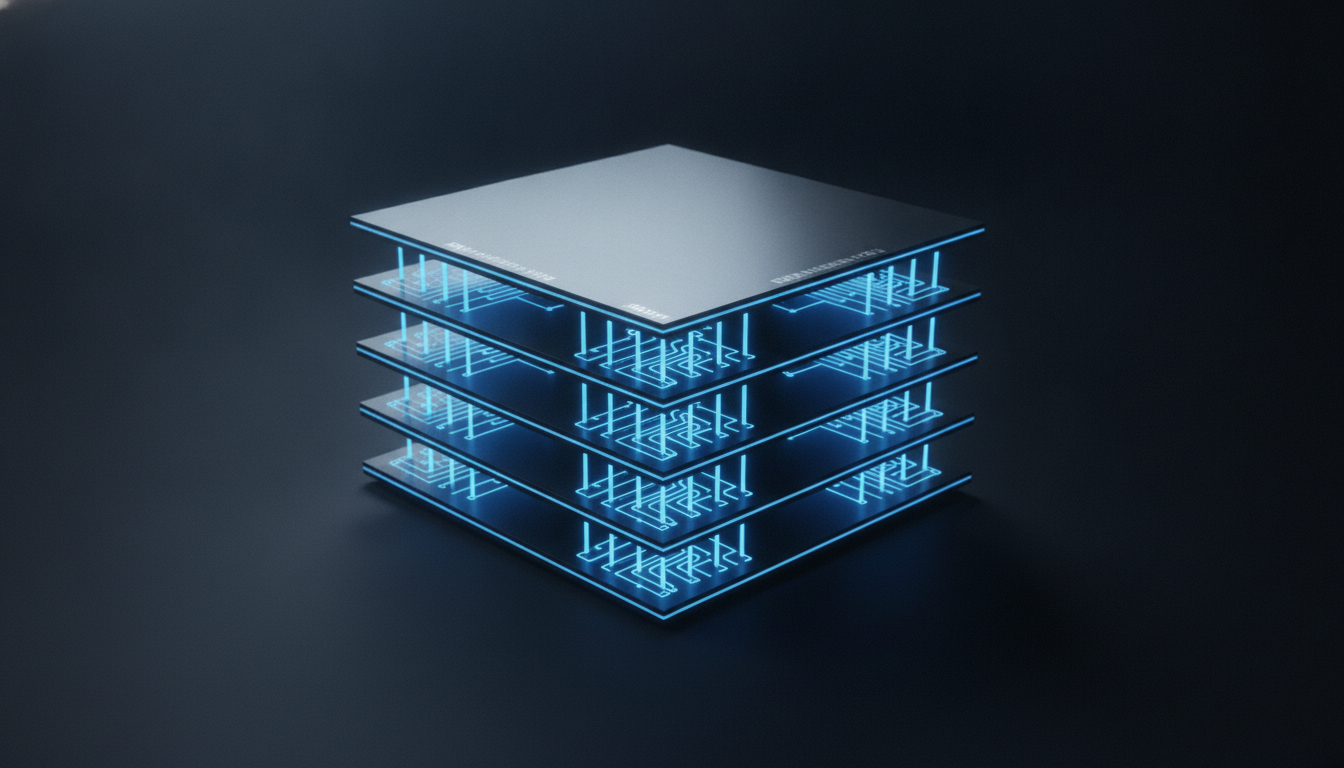
HBM(High Bandwidth Memory, 고대역폭 메모리)이란 여러 개의 D램 칩을 수직으로 쌓아 올린 뒤 실리콘 관통 전극(TSV) 기술로 연결하여, 기존 D램 대비 데이터 전송 속도와 대역폭을 비약적으로 끌어올린 고성능 3차원 적층 메모리 반도체입니다. 인공지능(AI) 모델의 대규모 연산 처리를 위해 GPU와 초고속으로 방대한 양의 데이터를 주고받아야 하는 고성능 컴퓨팅(HPC) 시스템의 핵심 부품으로 자리 잡았습니다.
1. HBM의 기본 개념과 등장 배경
전통적인 컴퓨터 구조(폰 노이만 구조)에서는 연산을 담당하는 프로세서(CPU, GPU)와 데이터를 저장하는 주기억장치(DRAM)가 물리적으로 분리되어 있습니다. 연산 처리 장치의 속도는 기술 발전과 함께 비약적으로 빨라진 반면, 메모리와 프로세서 사이에서 데이터를 주고받는 통로(대역폭)의 발전 속도는 상대적으로 더뎌 ‘메모리 벽(Memory Wall)’이라 불리는 병목 현상이 발생했습니다.
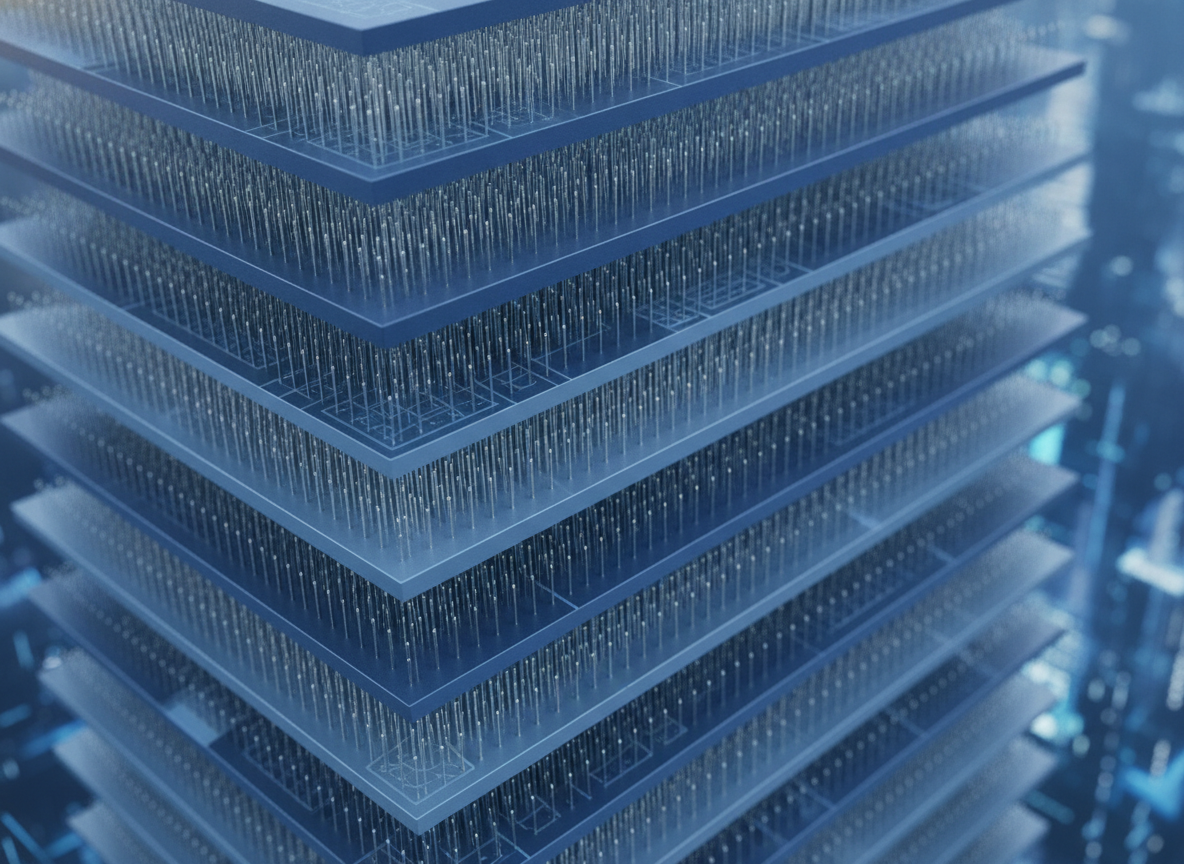
특히 딥러닝과 대규모 언어 모델(LLM)의 등장으로 초당 테라바이트(TB) 단위의 데이터 전송이 요구되면서, 평면에 D램을 나열하는 기존 인터페이스 방식은 전력 소모와 메인보드 면적 한계에 부딪혔습니다. 이를 극복하기 위해 국제반도체표준협의기구(JEDEC) 규격을 바탕으로 D램을 아파트처럼 수직으로 쌓아 데이터 통로의 수를 수천 개로 확장한 기술이 바로 HBM입니다.
핵심 정의:
HBM은 평면 배열의 한계를 넘어 D램을 3차원 수직으로 적층함으로써 통로(I/O, 입출력 핀)의 수를 대폭 늘려 초고속 데이터 전송 대역폭을 구현한 차세대 메모리 규격입니다.
2. HBM의 핵심 구조와 작동 원리 (TSV와 인터포저)
HBM이 초고속 대역폭을 구현할 수 있는 기술적 비결은 패키징과 배선 기술에 집약되어 있습니다.
실리콘 관통 전극 (TSV, Through Silicon Via)
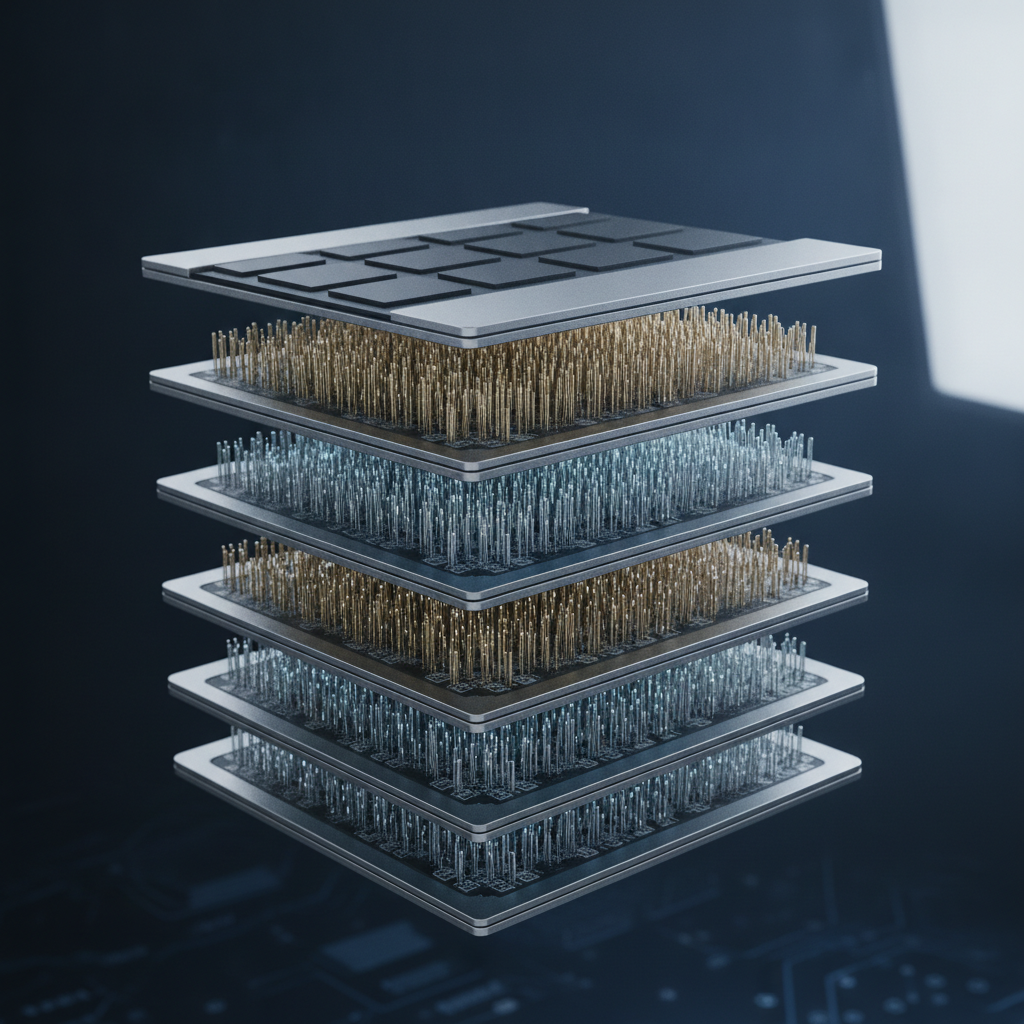
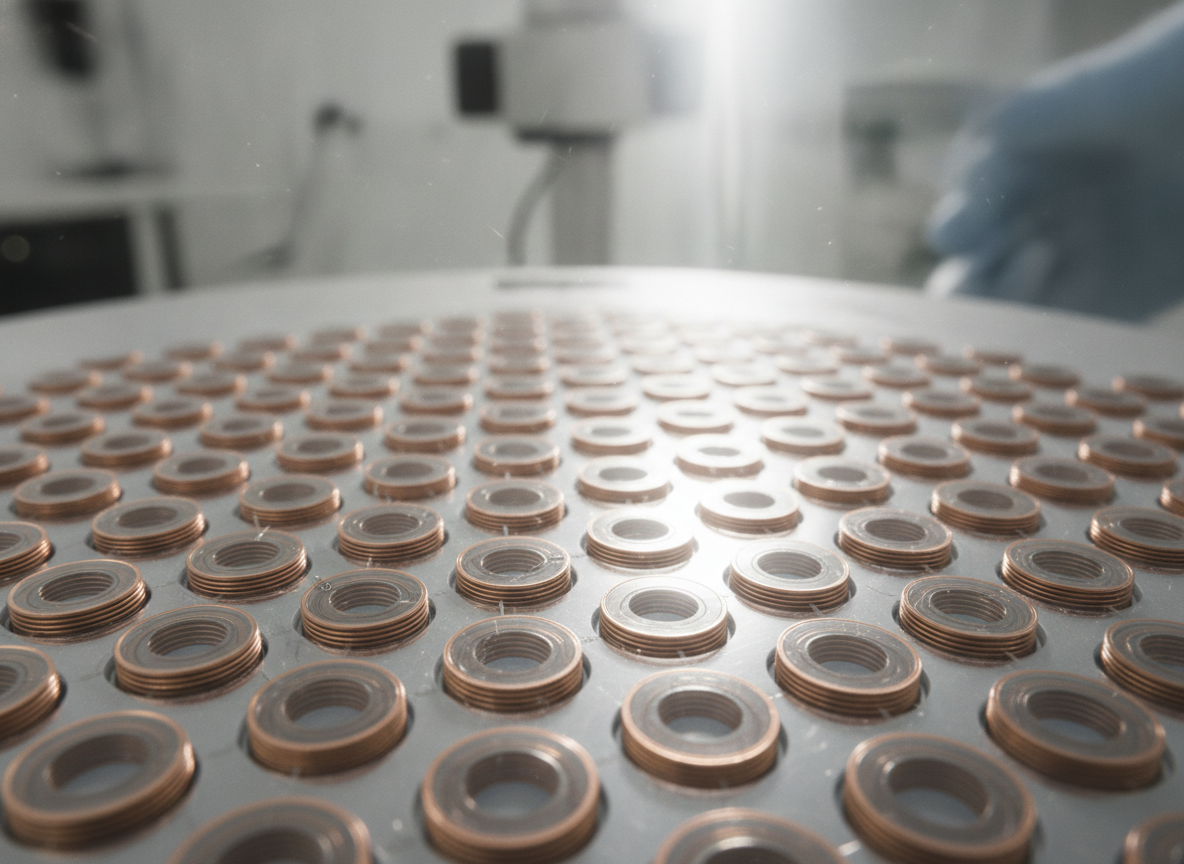
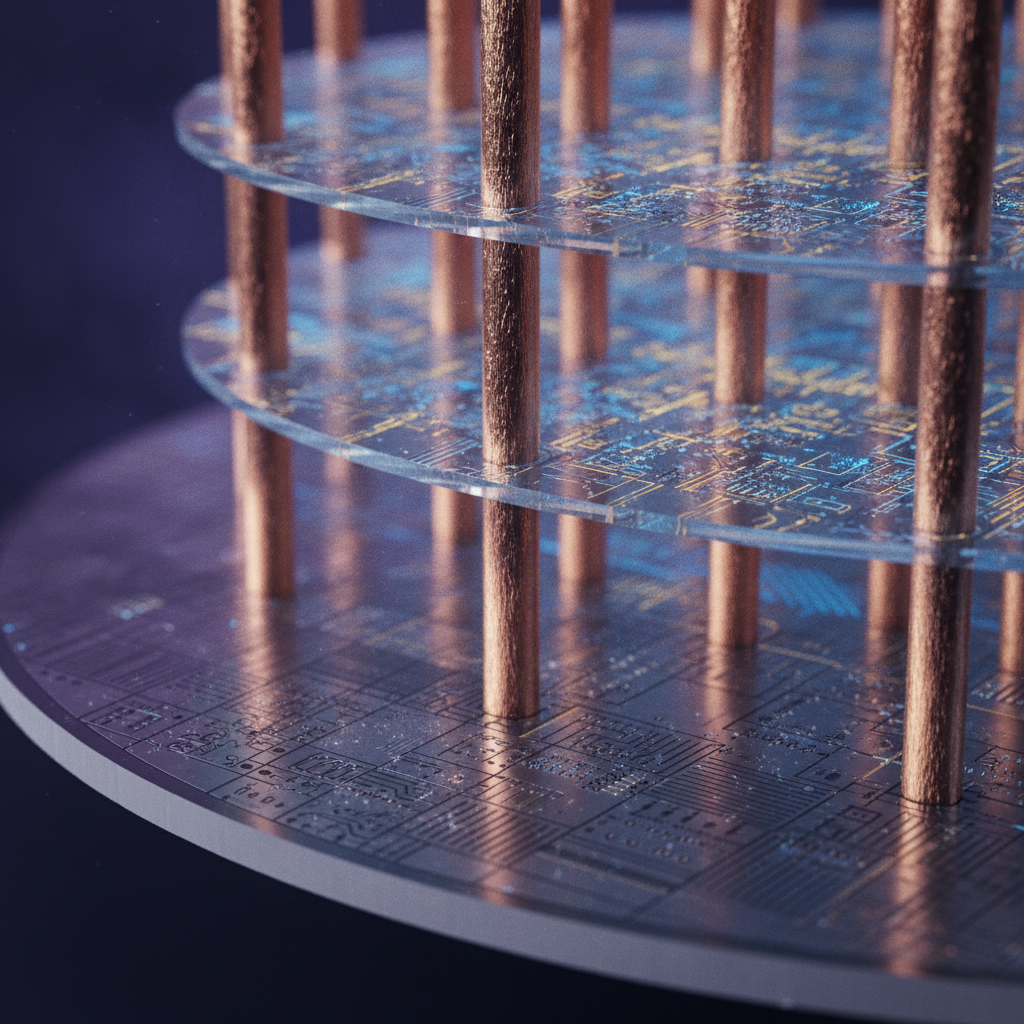
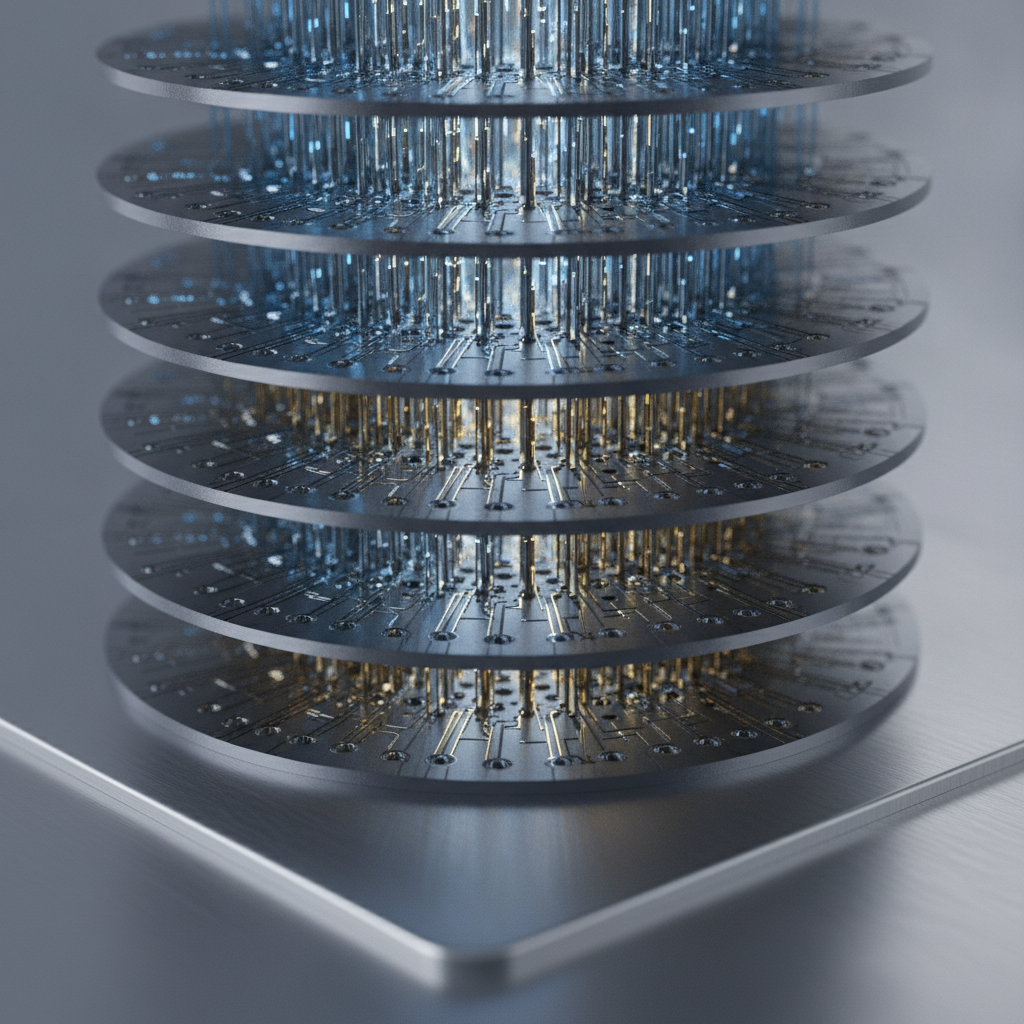
기존 D램은 칩 가장자리를 금속 와이어로 연결하는 와이어 본딩 방식을 사용했습니다. 반면 HBM은 머리카락 굵기보다 미세한 수천 개의 구멍을 칩에 직접 뚫고 구리 등의 전도성 물질로 채워 상하부 칩을 수직으로 직접 관통 연결하는 TSV 공정을 적용합니다. 이를 통해 신호 전달 거리를 마이크로미터 단위로 단축시키고 지연 시간과 전력 손실을 줄입니다.
베이스 다이(Base Die / 로직 다이)와 실리콘 인터포저
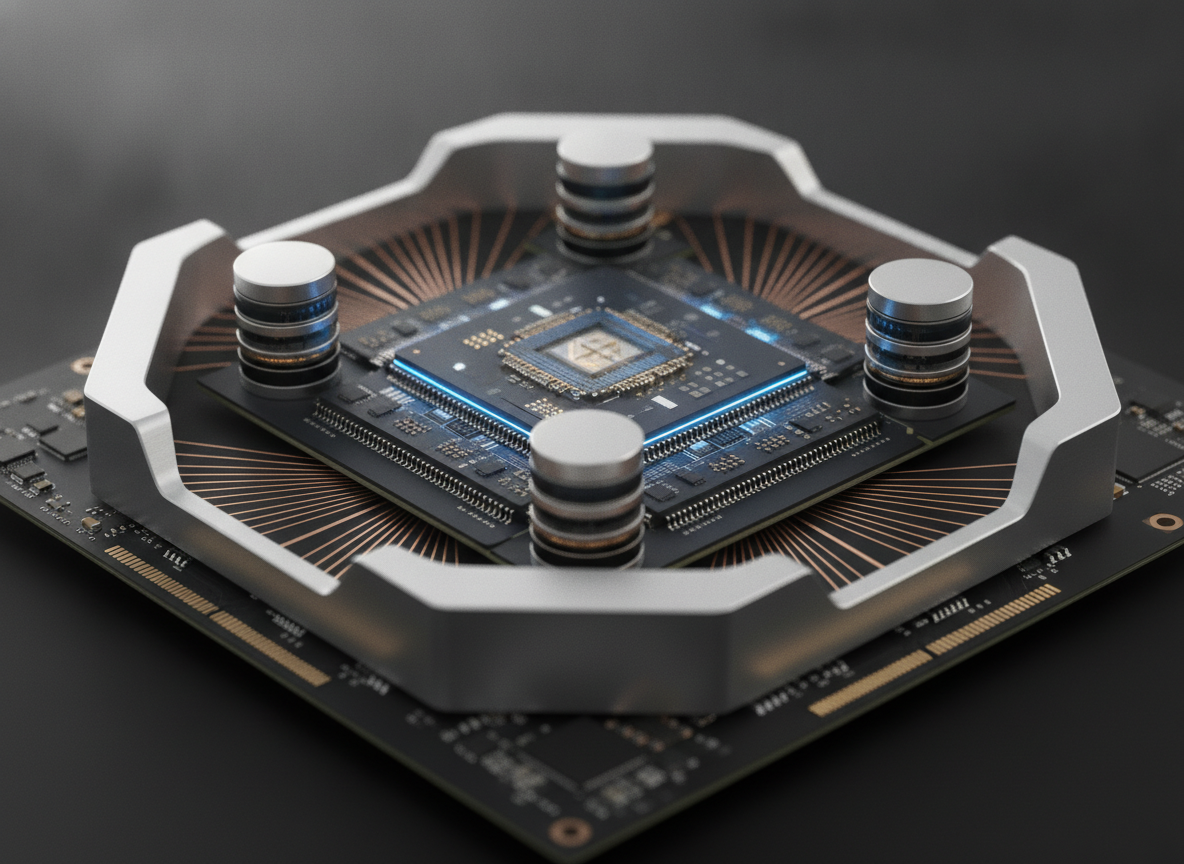
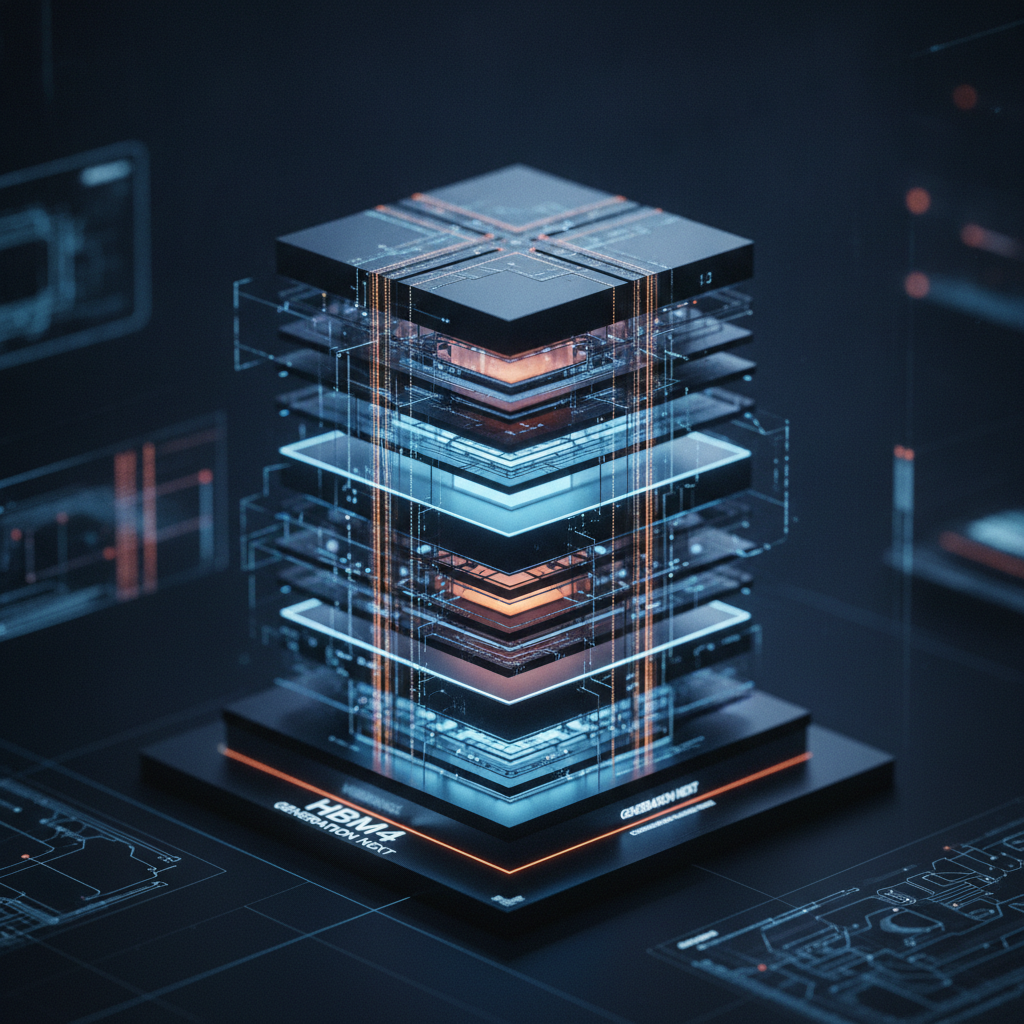
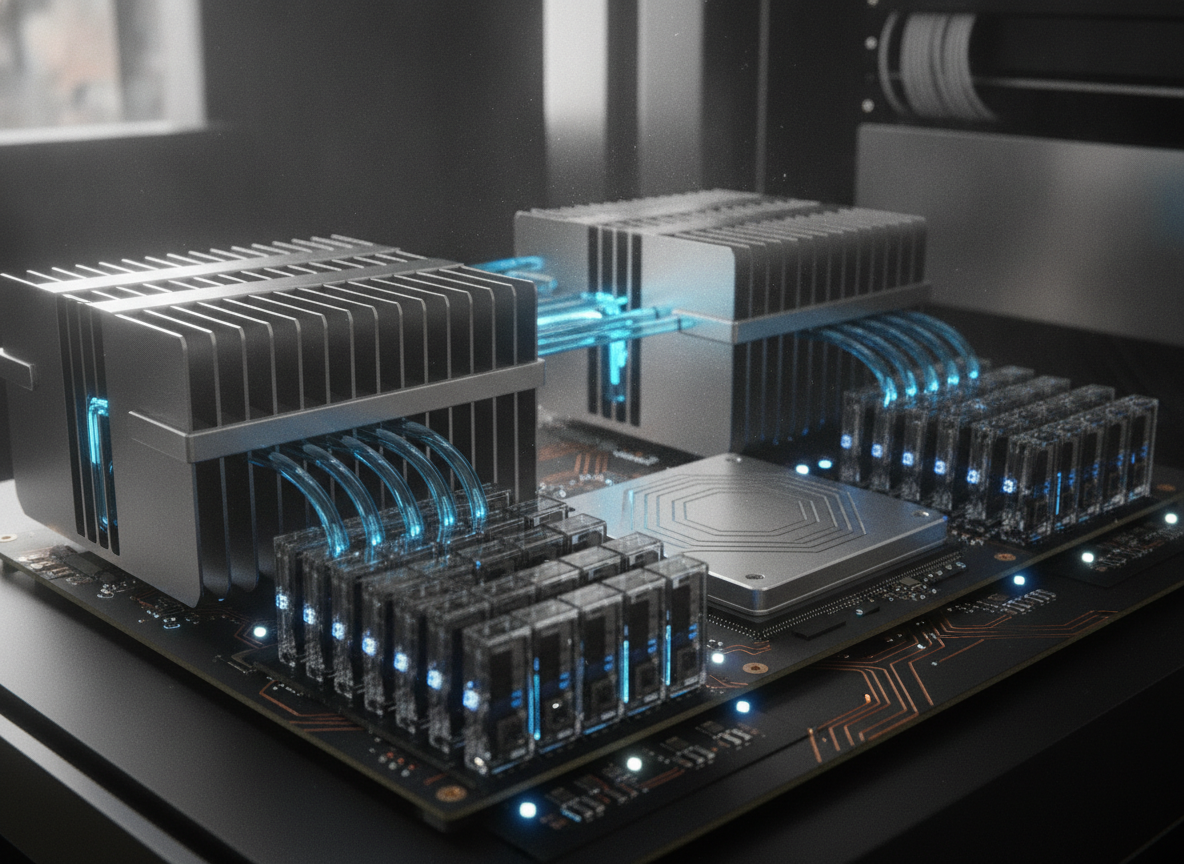
수직으로 적층된 D램 코어 다이들 맨 아래에는 이를 총괄 제어하는 베이스 다이(Base Die)가 위치합니다. 그리고 이 HBM 적층체는 GPU와 함께 기판 위에 나란히 실장되지 않고, 실리콘 재질의 미세 회로 기판인 인터포저(Interposer) 위에 2.5D 패키징 형태로 나란히 배치되어 GPU와 밀접하게 초단거리로 연결됩니다.
3. 전통 D램(GDDR)과 HBM의 차이점 비교
HBM과 고성능 그래픽용 메모리인 GDDR(Graphics DDR)은 고속 연산을 지원한다는 공통점이 있으나, 설계 철학과 작동 방식에서 극명한 차이를 보입니다.
| 비교 항목 | 기존 그래픽 메모리 (GDDR6/7) | 고대역폭 메모리 (HBM3E 기준) |
|---|---|---|
| 배치 구조 | 인쇄회로기판(PCB) 평면 배치 (2D) | 실리콘 인터포저 위 수직 적층 (2.5D / 3D) |
| 데이터 통로 수 (Bus Width) | 32비트 (채널당 소규모 통로) | 1,024비트 (수천 개의 TSV 배선) |
| 동작 방식 비유 | 소수의 차선에서 스포츠카가 극도로 질주 | 수백 개의 차선으로 대형 트럭 수백 대가 동시 운행 |
| 데이터 전송 대역폭 | 초당 수십~수백 기가바이트 (GB/s) | 초당 1.1~1.2 테라바이트 (TB/s) 이상 |
| 실장 면적 | 넓은 메인보드 면적 소모 | 수직 적층으로 기판 실장 면적 극소화 |
| 제조 비용 및 난이도 | 상대적으로 저렴하고 양산 안정성 높음 | 첨단 패키징 비용 수반으로 단가가 매우 높음 |
GDDR은 데이터가 지나가는 도로의 폭(32비트)은 좁지만 개별 신호 전송 속도(Pin Speed)를 극단적으로 끌어올리는 방식을 택합니다. 반면 HBM은 1,024비트에 달하는 광활한 도로 폭을 구축하여, 개별 통로의 속도를 무리하게 올리지 않고도 막대한 양의 데이터를 동시에 병렬 전송합니다.
4. HBM 세대별 발전 단계 (1세대부터 HBM4까지)
JEDEC 표준에 따라 HBM은 세대를 거듭하며 적층 단수와 대역폭 성능이 발전해 왔습니다.
| 세대 명칭 | 출시 / 표준화 시기 | 최대 대역폭 (스택당) | 주요 적층 구조 및 특성 |
|---|---|---|---|
| HBM (1세대) | 2013~2015년 | 128 GB/s | 4단 적층 (4-Hi), 기본 JEDEC 표준 수립 |
| HBM2 (2세대) | 2016~2018년 | 256~307 GB/s | 4단 / 8단 적층, 고성능 컴퓨팅 도입 본격화 |
| HBM2E (3세대) | 2020년 | 410~460 GB/s | 8단 적층, 신호 무결성 및 방열 구조 개선 |
| HBM3 (4세대) | 2022년 | 819 GB/s | 12단 적층 본격화, 대형 클라우드 AI 가속기 탑재 |
| HBM3E (5세대) | 2023~2024년 | 1.18~1.2 TB/s 이상 | 8단 / 12단(36GB), 첨단 방열 소재(MR-MUF 등) 적용 |
| HBM4 (6세대) | 2025~2026년 이후 본격 양산 | 1.5~2.0 TB/s 이상 목표 | 2,048비트 I/O 확장, 파운드리 첨단 로직 공정 결합 |
특히 차세대 규격인 HBM4부터는 데이터 전송 통로 수가 기존 1,024개에서 2,048비트로 두 배 늘어납니다. 또한 하단의 베이스 다이를 기존 메모리 공정이 아닌 최첨단 파운드리 로직 공정(3nm~4nm급)을 활용해 고객 맞춤형으로 생산하는 구조적 전환점을 맞이하고 있습니다.

5. 생성형 AI 시대에 HBM이 필수적인 이유
챗GPT를 비롯한 대규모 언어 모델(LLM)과 생성형 인공지능 알고리즘은 수천억 개에서 수조 개에 이르는 매개변수(Parameter)를 동시에 연산해야 합니다.
- 초거대 가중치 데이터의 실시간 전송: AI 모델 추론과 학습 시 GPU 코어가 쉬지 않고 연산할 수 있도록 메모리가 매초 수 테라바이트의 가중치 데이터를 끊김 없이 밀어 넣어주어야 합니다.
- 전력 소비 효율화: 수만 대의 가속기가 가동되는 AI 데이터센터에서는 전력 및 발열 관리가 핵심 과제입니다. HBM은 병렬 데이터 전송 방식을 통해 동일 대역폭 기준 GDDR 대비 전력 소비량을 대폭 절감합니다.
- 서버 랙 공간의 물리적 한계 극복: D램을 평면에 펼쳐 놓으면 서버 보드가 지나치게 비대해집니다. HBM의 3D 수직 적층은 좁은 면적에 고용량을 구현하여 고밀도 데이터센터 구축을 가능케 합니다.
6. 기술적 난제와 제조 공정의 한계
HBM은 압도적인 성능을 제공하지만, 극도로 높은 공정 난도와 비용 장벽이 존재합니다.
- 발열 문제와 열 팽창: 칩을 8단, 12단, 16단으로 얇게 갈아내어 촘촘하게 쌓기 때문에 중심부에서 발생하는 열을 외부로 방출하기 어렵습니다. 발열 제어를 위해 액체 형태의 보호재를 채우는 첨단 본딩(MR-MUF 등) 기술 경쟁이 치열합니다.
- 수율(Yield) 리스크: 여러 장의 D램 칩 중 단 하나의 칩이나 단 하나의 TSV 전극에만 불량이 생겨도 스택 전체를 폐기해야 하므로 일반 D램 대비 완제품 수율 확보가 까도롭습니다.
- 높은 생산 단가: 일반 D램 대비 수 배 이상 높은 가격으로 인해 아직은 일반 소비자용 PC나 스마트폰에 대중적으로 적용되기 어렵고, 고가의 엔터프라이즈 AI 서버 및 슈퍼컴퓨터 위주로 채택되고 있습니다.

7. 자주 묻는 질문 (FAQ)
8. 결론: 차세대 AI 메모리 반도체의 방향성
HBM은 단순한 데이터 저장 공간에 머물렀던 전통적인 메모리 반도체의 역할을 '프로세서와 대등하게 연산 효율을 좌우하는 핵심 파트너'의 지위로 격상시켰습니다. 연산 장치인 GPU가 아무리 뛰어나도 이를 뒷받침할 HBM의 데이터 공급 능력이 부족하면 인공지능 인프라는 온전한 성능을 발휘할 수 없습니다.
향후 HBM 기술은 16단 이상의 초고다층 적층, 2,048비트 기반의 HBM4 표준화, 나아가 메모리 내부에 자체 연산 기능을 통합하는 PIM(Processing-In-Memory) 기술과의 결합으로 진화하며 미래 인공지능 산업의 하드웨어 한계를 계속해서 넓혀갈 것입니다.
- JEDEC Solid State Technology Association: High Bandwidth Memory (HBM) DRAM 표준 규격서 (JESD235 계열)
- 한국반도체산업협회(KSIA): 고대역폭 메모리 기술 동향 및 차세대 패키징 분석 보고서
- IEEE Xplore Microelectronics: TSV 기반 3D IC 적층 및 인터포저 패키징 구조 논문